短消息、夹杂英文或拼写不规范时,HelloWorld跨境电商助手有时会把葡萄牙语识别成西班牙语,或把马来语与印尼语、挪威语与丹麦语等相近语言互相判错。识别错了,译文语气和用词会偏离买家本意,回复也可能发到错误目标语言。处理原则是:先按症状分诊,再手动指定源语言重译,发信前核对目标语言,必要时用正确语言致歉重发;菜单名称以当前版本为准,平台沟通规则以平台最新规则为准。
下面按「诊断排查实验室」流程走一遍:先看哪些语言容易被混,再分析为什么会错,接着在 HelloWorld跨境电商助手里做手动纠正与复测,最后用站点、收件国家、特有字母等线索确认买家真实语言,并约定团队默认设置。文中订单号、买家名与消息原文均为示例,不代表真实账号。
症状清单:哪些语言容易被识别混
实验室接诊时,最先对照的是「易混语言对」。最常见的是葡萄牙语与西班牙语:字母表高度重叠,短句里又常出现相同的问候词或借词,自动识别模型在样本不足时容易把葡语判成西语,或把拉美西语判成葡语。第二组是马来语与印尼语,书写系统接近、日常购物词大量共用,短消息几乎没有区分特征。第三组是挪威语与丹麦语,拼写和词形相近,买家若只用三五个词询价,系统几乎只能靠概率猜测。
还有一些次常见组合也会进实验室:荷兰语与德语短句、捷克语与斯洛伐克语、克罗地亚语与塞尔维亚语的拉丁字母写法。它们不一定每天都出现,但一旦出现,错译带来的尴尬和差评成本并不低。把易混对写进团队墙,比事后抱怨「翻译怎么这么傻」更有用。
- 列出本店近三个月实际接到过的语种,标出「易混对」与「几乎不会混」两类。
- 对易混对准备一页对照卡:特有字母、高频购物词、站点默认语言(示例:巴西站默认葡语、西班牙站默认西语)。
- 在 HelloWorld跨境电商助手会话侧栏或备注栏写上「疑似语种待核」,避免同事直接按错误译文回复。
症状清单的意义是缩小排查范围。实验室不要求你一次学会所有小语种,只要能在葡西、马印、挪丹这几组上快速举手说「先别自动回」,就已经挡住大半事故。
病因分诊:为什么会把语言识别错
自动语言识别依赖文本统计特征。消息太短时,特征不够,模型只能在相近语言之间掷骰子。买家夹杂英文商品型号、尺码缩写或表情符号时,葡语或西语的特征会被稀释。拼写不规范、口音式写法、故意省略重音符号,也会让葡语看起来更像西语,或让马来语更像印尼语。
分诊时还要区分「识别错」和「翻译差」。识别错是指系统把源语言标签标成了另一种语言,后续整段翻译都按错误语言走;翻译差是源语言对了,但用词不贴切。本篇只处理前一种。若你发现译文读起来「像西语腔在讲葡语的事」,优先怀疑识别标签,而不是先怪模型文笔。
- 复制买家原句,数一数有效单词是否少于八到十个;过短则默认进入「易混高风险」。
- 检查是否夹杂英文品牌名、SKU、尺码(示例:size M、model X);夹杂越多,越要人工指定源语言。
- 看有没有缺重音、错字母、聊天缩写;不规范拼写时不要相信第一次自动识别结果。
- 在 HelloWorld跨境电商助手里对照「识别出的源语言」与「你根据站点与国家判断的语言」是否一致,不一致就进入纠正流程。
分诊结论要写进备注栏,格式示例:「短消息+夹英文,疑似葡语被识成西语,待手动指定」。这样下一班客服不用重新猜病因,复测也有据可查。
在 HelloWorld跨境电商助手里手动纠正
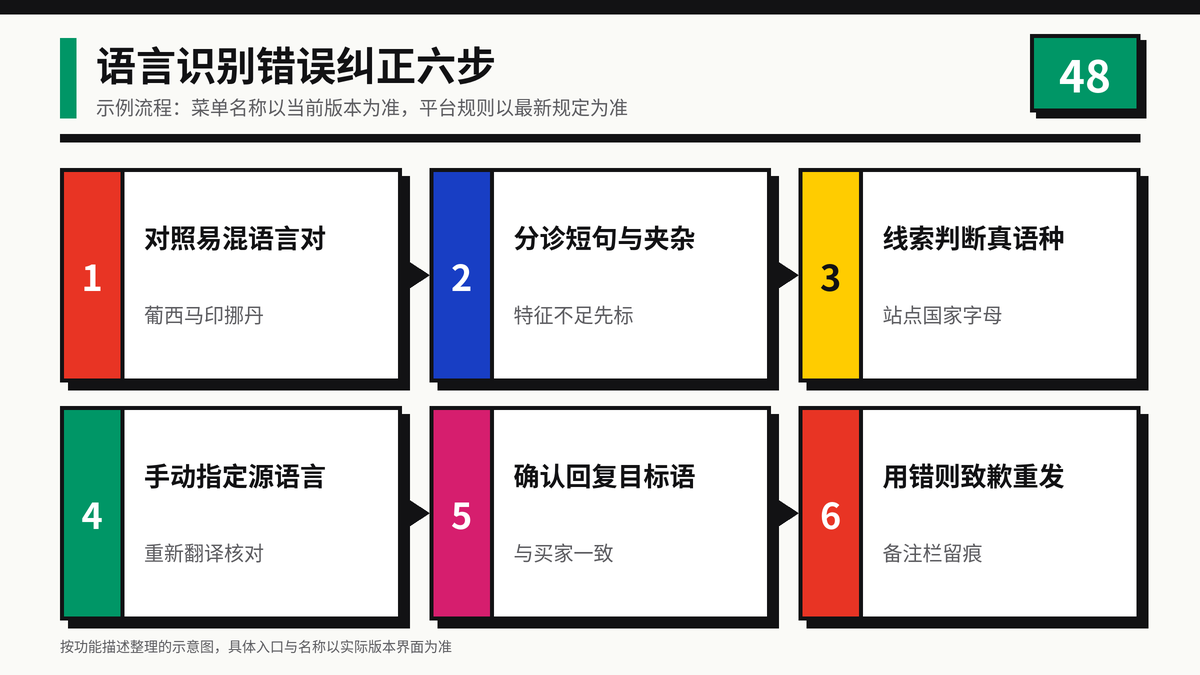
纠正是实验室的核心操作台。目标不是否定自动翻译,而是在易混场景下接管「源语言」与「目标语言」两个旋钮。菜单名称与按钮位置以当前版本为准;若你看到的文案不同,按「指定源语言 / 重新翻译 / 选择回复语言」等同功能理解即可。
手动指定源语言重新翻译(以当前版本为准)
当系统把葡萄牙语标成西班牙语时,先不要直接用错误译文回买家。打开该条消息的翻译面板或语言选项,将源语言手动指定为葡萄牙语(或你分诊认定的语言),再触发重新翻译。重译后把译文回译成中文读一遍,确认询价、尺码、退换意图没有被西语腔带偏。
- 在会话中定位被误识别的买家原句,保留原文,不要只留错误译文。
- 打开语言或翻译相关菜单(以当前版本为准),找到「源语言」或「检测语言」选项。
- 将源语言改为葡萄牙语(示例),或马来语、挪威语等你已分诊确认的语种。
- 点击重新翻译或刷新译文,等待新结果生成。
- 用中文回译或对照关键名词,核对尺码、颜色、退款、物流等意图是否正确。
- 若重译仍离谱,换用更长上下文:把买家前后两三条消息一并选中再译,避免单句过短。
手动指定源语言是可复测动作:同一原文,改标签前后译文应有可感知差异。若改成葡语后译文突然通顺、术语贴合巴西站习惯,说明病因确实是识别标签,而不是商品知识库缺失。
回复时确认目标语言是否与买家一致
源语言纠正后,还要确认「你准备发出去的语言」是否等于买家真实语言。常见失误是:看懂了葡语原文,却仍用西班牙语模板回复;或系统默认按店铺主语言站点(示例:西班牙站)输出西语。发信前在 HelloWorld跨境电商助手的回复框检查目标语言标签,必要时手动切换到葡萄牙语再发送。
- 草稿写完后,先看回复框或预览区显示的目标语言名称。
- 与买家原句语种、收件国家默认语种对照;不一致则手动切换。
- 用翻译功能生成目标语草稿后,再回译成中文审一遍语气与承诺边界。
- 发送成功后,在备注栏记「已用葡语回复,源语言曾误标西语」,供质检抽查。
源语言与目标语言是两个独立旋钮,实验室要求两个都绿灯才允许发出。只修一个,另一头仍可能把「听懂了」变成「回错了」。
判断买家真实语言的线索:站点、收件国家、特有字母和词汇
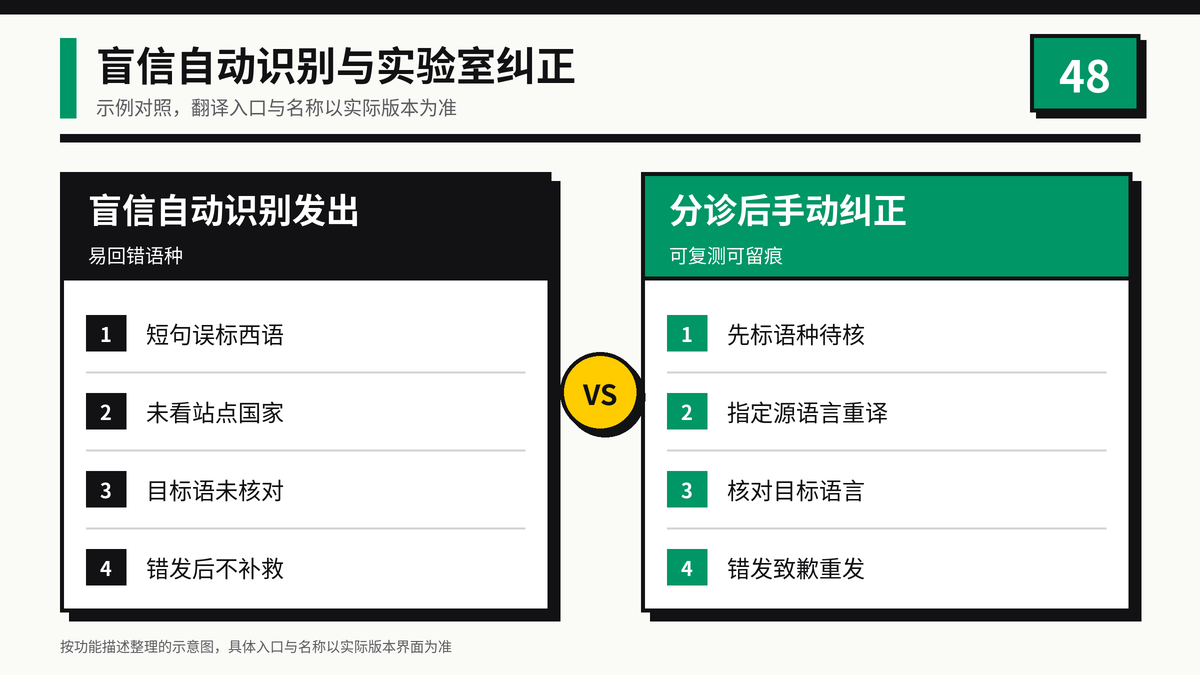
当原文短到几乎无法识别时,实验室改用外部线索。第一线索是下单站点:巴西站、葡萄牙站的买家更可能写葡语;西班牙站、墨西哥站更可能写西语。第二线索是收件国家与城市:收件国为巴西而消息被标成西语,优先按葡语重试。第三线索是特有字母与词汇:葡语常见 ã、õ、ç 以及 você、obrigado 等;西语常见 ñ、¿¡ 以及 usted、gracias 等。马来语与印尼语也可借站点与高频词区分,但短句时仍建议人工指定。
- 打开订单详情,记录站点站点名与收件国家(示例信息),不要只看自动语言标签。
- 扫描原文是否出现特有字母;有 ã/õ 更倾向葡语,有 ñ 更倾向西语。
- 对照团队易混词表:同一意思在两种语言里的常用写法是否匹配原文。
- 线索互相矛盾时(示例:西班牙站下单但收件巴西且出现 ã),以收件国家与特有字母优先,站点次之。
- 把最终判定写进 HelloWorld跨境电商助手备注栏,并手动指定源语言复测一次。
线索法不是语言学考试,而是客服台的快速量表。训练新人时用十组真实脱敏短消息做测验,要求在两分钟内给出「语种判定 + 依据」,通过后再开放独立回复权限。
回复用错语言后的补救:致歉并用正确语言重发
若错误译文已经发出,实验室进入补救段,而不是假装没发生。补救结构固定:先致歉说明刚才语言弄错,再用不含指责系统的口吻重申正确答复,最后确认买家是否还需要补充信息。避免长篇解释算法原理;买家要的是被听懂,不是技术说明会。
- 立刻在同一会话用正确语言发送致歉加正解,不要另开无关话题。
- 致歉句保持短:说明上一封语言有误,以下内容为准(示例口径,按语种翻译)。
- 把正确答复完整重写一遍,不要让买家翻聊天记录去拼答案。
- 检查 HelloWorld跨境电商助手是否仍显示错误目标语言;若是,先切换再发,避免连续错。
- 在备注栏记录事故:误标语种、已重发、是否获买家确认,便于班后复盘。
- 若买家已因语言错误表示不满,按店铺售后政策给出可选补偿(示例:小额优惠),政策以店铺规定为准。
补救是否合格,看复测指标:买家是否继续用原语种正常沟通、是否重复投诉「看不懂」。连续两周同语种对零事故,才能认为纠正流程真正落地。
团队约定:相近语言站点的默认翻译设置
个人纠得好,不如团队约定稳。对巴西站、葡萄牙站会话,建议默认源语言倾向葡萄牙语,或至少关闭「完全盲信自动检测」的激进策略(具体开关以当前版本为准)。对西班牙站与拉美西语站,默认西语,但遇到收件巴西或特有葡语字母时强制人工确认。马来与印尼、挪威与丹麦同理:按站点设默认,按线索升级人工。
- 召开十五分钟站立会,确认各站点的默认语种表,贴在客服看板。
- 在 HelloWorld跨境电商助手里为易混站点配置可执行的默认选项或快捷回复标签(以当前版本功能为准)。
- 规定:自动识别结果与默认表冲突时,必须手动指定后再回复,禁止「先发出去再说」。
- 每周抽查十封易混语种会话,统计误识别率与补救及时率,把结果反馈给培训。
- 把高频误判原句收进内部例句库,供新人练习指定源语言,不外传买家隐私。
团队约定要把「谁有权改默认」「冲突时听谁的」写清楚。实验室经验是:默认表由运营与资深客服共签,一线客服负责执行与上报例外,而不是每人私下改偏好导致同一买家收到两种语言风格。
复测环节建议固定在每日打烊前十分钟:筛选当日标签含「语种待核」或「误识别」的会话,确认均已手动纠正且无错误目标语言外发。未闭环的会话移交夜班,并在 HelloWorld跨境电商助手里保留同一备注线索,避免信息在交接中丢失。
若你同时运营多个西语国家站,还要在默认表里区分欧洲西语与拉美西语的用词偏好;那是翻译润色问题,与本篇的「识别标签错误」不同,但可以在纠正源语言之后接着做。先保证语种标签对,再谈用词是否本地化。
对极度短的消息(示例:只有一个「sim」或「ok」),不要单独做语种终裁,应结合上一轮买家语言与订单站点;必要时先用中性确认句追问一句完整问题,再进入正式答复。HelloWorld跨境电商助手适合处理完整会话上下文,单字消息本身信息量不足,强行自动识别只会提高误判率。
质检评分可以把「易混语种是否先分诊」列为必选项。抽到葡西、马印、挪丹会话时,没有备注栏分诊记录或没有手动指定痕迹的,直接记为流程不合格,即使碰巧回对了语言也不给满分。这样能把运气排除出评价体系,让实验室流程真正可复制。
工具再聪明,也替不了「短文本 + 相近语言」场景下的人工一眼。把 HelloWorld跨境电商助手的自动识别当作初筛,把手动指定与线索量表当作确诊,把致歉重发当作急救,三位一体,语言识别错误就会从客诉热点变成可管理的低概率事件。
常见问题
为什么葡语总被认成西语,反过来却较少?
训练语料与站点流量里西语占比往往更高,短句特征又高度重叠,模型在不确定时更容易倒向更高频的西语标签。这不是你操作独有的问题。对策是对巴西、葡萄牙相关订单提高人工指定频率,而不是反复重试自动检测。
手动指定源语言后,历史消息会不会一起变?
多数情况下,重新翻译作用于你选中的消息或当前会话视图,是否回溯全部历史以当前版本为准。发送前仍以预览区实际语言为准,不要假设历史气泡已全部自动更正。
只用英语回复能不能避开识别问题?
英语可以作临时沟通桥,但不是所有买家都愿意或能够用英语完成售后。能确认买家语种时,仍应用买家语言答复;英语仅作短暂确认或买家主动切换时的选择。
线索互相矛盾时听哪一条?
优先顺序建议:特有字母与完整句子用词,大于收件国家,大于下单站点,大于自动识别标签。全部矛盾时,用正确语言各发一句简短确认,请买家用母语重述需求,再继续处理订单。
团队默认设置改错了怎么办?
立即改回已共签的默认表,并在 HelloWorld跨境电商助手公告或内部群同步。对改错期间已外发的会话做一次筛选复测,必要时按补救流程致歉重发。默认表变更必须留变更人与时间,禁止静默修改。